

 Nos encontramos ante un punto de inflexión. Las organizaciones realizan importantes inversiones en modelos de inteligencia artificial y, sin embargo, muchas siguen sin obtener el retorno que esperaban. No porque los modelos fallen, sino porque la base sobre la que operan, los datos, no está en condiciones de sostenerlos.
En las conversaciones que mantenemos cada día con grandes organizaciones vemos un patrón cada vez más claro: muchas han avanzado rápidamente en sus iniciativas de IA, pero el verdadero reto aparece cuando llega el momento de llevarlas a producción, escalarlas e integrarlas de forma segura con sus datos empresariales. Entonces formulamos una pregunta: ¿sobre qué base opera realmente esta IA?
Esta no es solo una reflexión empresarial. Durante su reciente visita a Francia, León XIV ha vuelto a situar a la inteligencia artificial como uno de los grandes desafíos de nuestro tiempo. Tal y como expuso en la encíclica Magnifica Humanitas, el debate sobre la IA no debe limitarse a cuál es el potencial de esta tecnología, sino extenderse a quién establece sus objetivos y bajo qué principios se desarrolla.
La respuesta, casi siempre, conduce al mismo lugar: se invierte en IA antes de invertir en datos. Y cuando se profundiza un poco más, surgen otras cuestiones fundamentales: ¿quién controla el modelo? ¿dónde reside la información que lo alimenta? o ¿bajo qué jurisdicción se está operando?
Esas preguntas, que hasta hace poco solo se hacían en sectores muy regulados, hoy las tiene que plantear cualquier organización que quiera desplegar estas tecnologías con garantías reales. Porque la cuestión no es únicamente cómo construir una IA más potente, sino cómo hacerlo sobre una base que inspire confianza. Merece la pena detenerse a entender por qué.
El problema no estaba donde mirábamos
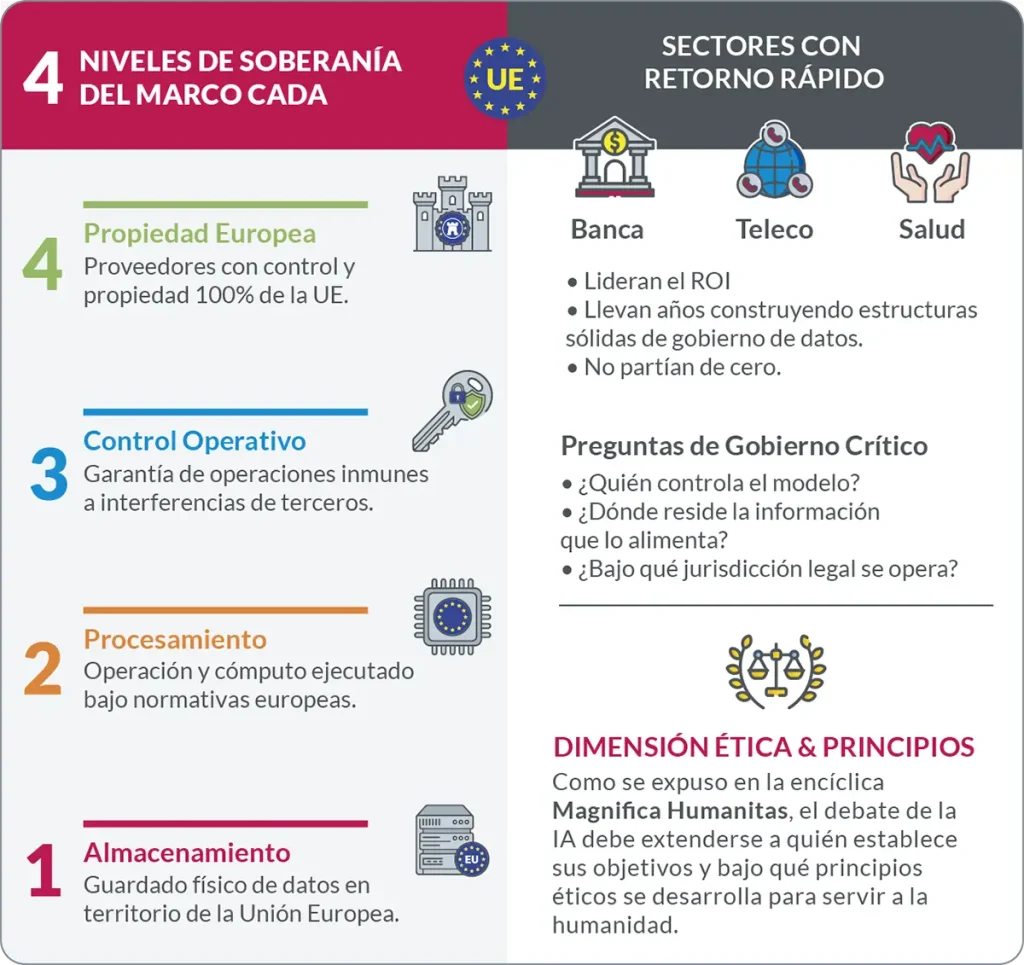
Durante los últimos dos años, la conversación sobre inteligencia artificial en las empresas ha girado en torno al modelo: qué proveedor, qué arquitectura, qué velocidad de adopción. Gartner estima que el gasto mundial en IA superará los 2,7 billones de dólares en 2026, un 49,5% más que el año anterior. Y una parte muy significativa de esa inversión ha ido a modelos y capacidad de cómputo.
Sin embargo, la escalabilidad sigue siendo el problema. La lección que estamos aprendiendo, a veces con coste, es que el modelo es solo el último eslabón. Una IA no es mejor que los datos sobre los que opera. Y esos datos, en la mayoría de las grandes organizaciones, están distribuidos en múltiples sistemas, con calidades desiguales, sin una gobernanza homogénea, y con una trazabilidad que no resistiría la revisión regulatoria que se avecina. Da igual la calidad del modelo si los datos que lo alimentan son incompletos, están fragmentados o no se pueden auditar.
Europa quiere garantizar la soberanía
El pasado 3 de junio, la Comisión Europea publicó el Paquete de Soberanía Tecnológica, cuya pieza central es el Cloud and AI Development Act (CADA), un conjunto de medidas que plantea una buena base y puede ser un camino para seguir.
La propuesta introduce un marco de soberanía de cuatro niveles para la contratación pública de servicios cloud e IA, con requisitos progresivos que van desde el simple almacenamiento en territorio europeo hasta la exigencia de que los proveedores sean de propiedad y control europeo, sin ningún tipo de interferencia jurisdiccional de terceros países.
Además, este planteamiento europeo pone el foco en sectores críticos o sensibles, como podrían ser sanidad, finanzas, justicia o energía, donde la dependencia de proveedores extranjeros representa un riesgo de soberanía real. Es, en esencia, una propuesta de ley de soberanía del dato con implicaciones directas para cualquier organización que opere en sectores críticos. Regula la capa sobre la que los modelos operan: dónde están los datos, quién los controla y bajo qué condiciones se procesan.
Si aun no has construido una estructura de gobierno del dato no tienes un problema de IA, tienes un problema de datos
El contexto que motiva esta regulación es también importante para entenderlo. Los grandes proveedores de nube estadounidenses concentran aproximadamente el 70% de los ingresos del mercado cloud europeo, según Synergy Research, y Europa depende de proveedores no europeos en más del 80% para sus productos e infraestructuras digitales clave.
Construir una estrategia de IA sobre esa dependencia no es solo un riesgo estratégico, es edificar sobre terreno que no controlamos. En los términos de la CADA, es un riesgo de soberanía cuantificable y auditable.
Llevar la IA a los datos
El tablero de juego ha cambiado. En la primera fase de la IA empresarial ganaba quien llegaba antes al modelo más avanzado. Ahora gana quien dispone de unos datos mejor preparados, mejor gobernados y bajo control.
Eso implica saber dónde están los datos; garantizar su calidad y trazabilidad, o asegurar que la IA que opera sobre ellos lo hace bajo las condiciones correctas de privacidad, seguridad y cumplimiento normativo. Además, hay que poder demostrar todo lo anterior ante un auditor o el regulador.
Pero, sobre todo, supone tener en cuenta una situación sobre la que cada vez más organizaciones están tomando consciencia: trasladar información sensible a sistemas o proveedores externos genera riesgos de seguridad, regulatorios y operativos que no siempre se pueden asumir.
La alternativa es llevar la IA directamente a los datos, y no al revés. Esta es precisamente la dirección que marcan alianzas como la que Cloudera ha establecido con Mistral. A través de ella se integran las capacidades avanzadas de inteligencia artificial de Mistral directamente en la plataforma híbrida de datos de Cloudera, para que las organizaciones puedan ejecutar IA sobre su propia información (en entornos cloud, on-premise o edge) sin renunciar al control ni a la flexibilidad. No se trata de elegir entre eficiencia y seguridad, sino de combinar ambas.
EL PUNTO DE INFLEXIÓN
Se invierte en IA antes que en datos
Las organizaciones realizan masivas inversiones en modelos de IA, pero sufren para llevarlas a producción y escalarlas porque la base sobre la que operan los datos no está preparada ni gobernada.
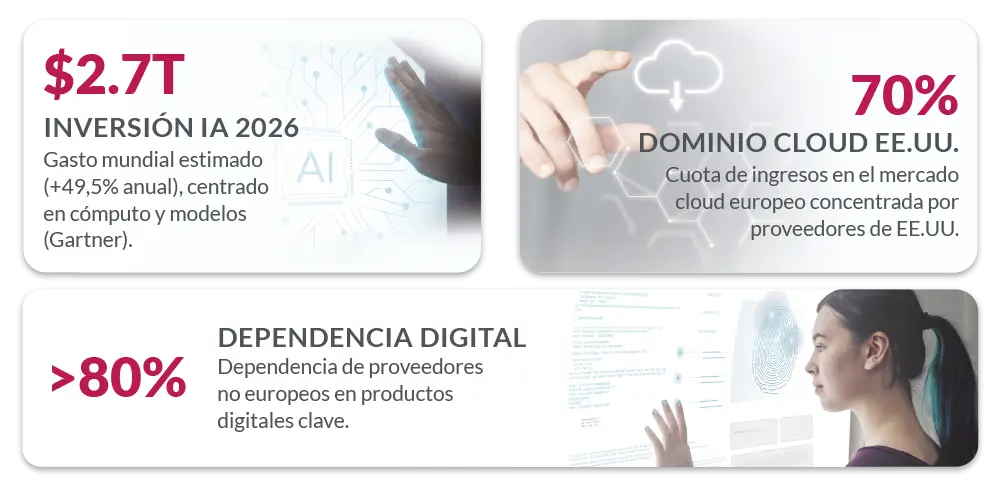
No es casualidad que los sectores que más rápido están obteniendo un retorno real de la IA (banca, telecomunicaciones, salud) sean precisamente los que más años llevan construyendo estructuras de gobierno del dato. No partían de cero. Tenían ya una base. Las organizaciones que aún no han hecho ese trabajo no tienen un problema de IA, tienen un problema de datos.
Las organizaciones que comprendan esto antes que las demás tendrán una ventaja que se construye con datos gobernados, con arquitecturas que permiten moverlos sin perder el control y con socios tecnológicos que no exigen elegir entre potencia y autonomía.
No se trata solo de una cuestión técnica, es la diferencia entre una IA que funciona y una IA que promete.